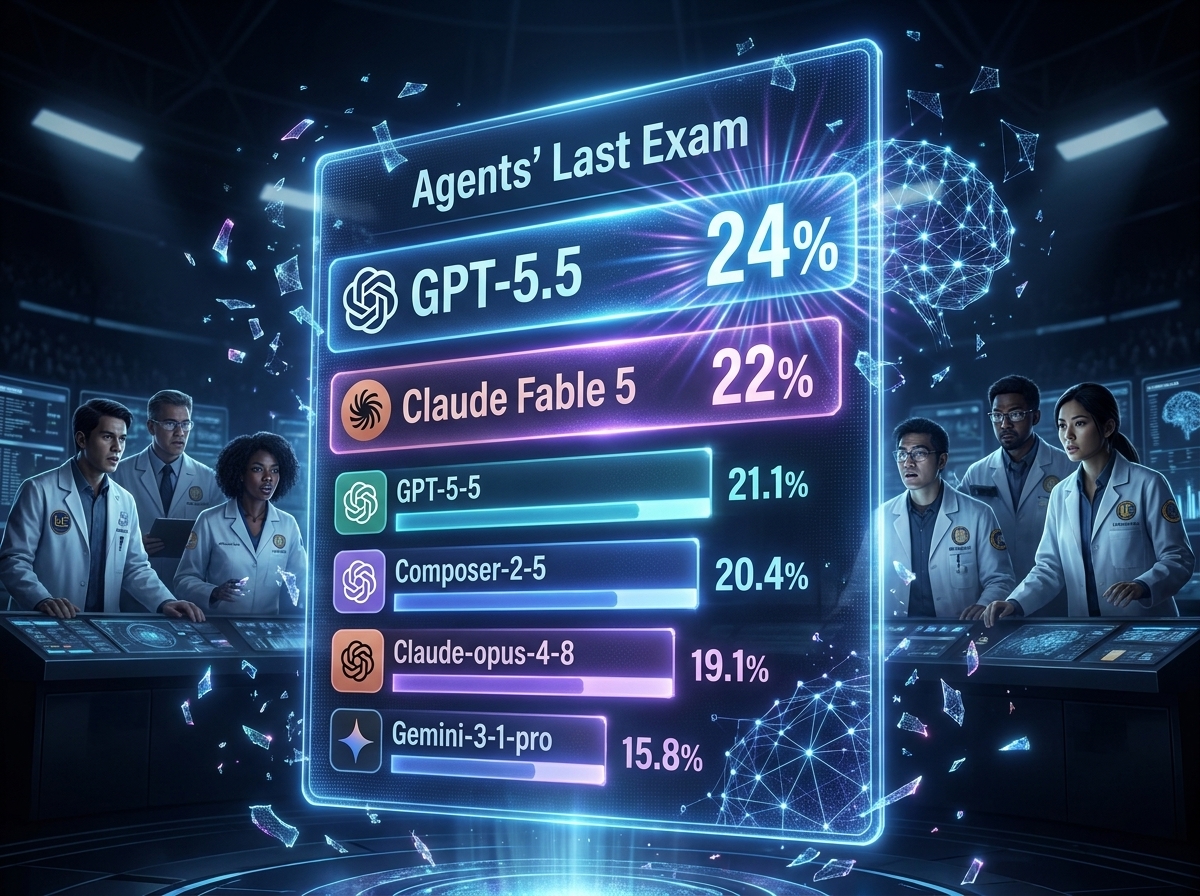
นักวิจัยจากศูนย์ RDI แห่งมหาวิทยาลัยแคลิฟอร์เนีย เบิร์กลีย์ ร่วมกับคณะที่ปรึกษาที่เป็นผู้เชี่ยวชาญเฉพาะทางกว่า 300 คน ได้เปิดตัว 'Agents’ Last Exam' (ALE) ซึ่งเป็นระบบทดสอบมาตรฐานใหม่ (Benchmark) ที่ออกแบบมาเพื่อวัดความสามารถของปัญญาประดิษฐ์ในการทำงานจริงที่มีมูลค่าทางเศรษฐกิจในระยะยาว แทนที่จะเป็นเพียงการแก้โจทย์เขียนโค้ดสั้นๆ แบบเดิมๆ
ผลการประเมินแรกสร้างความสั่นสะเทือนให้วงการอย่างมาก เมื่อโมเดล GPT-5.5 ของ OpenAI ที่เปิดตัวเมื่อเดือนเมษายนและทำงานผ่านโครงสร้าง Codex สามารถคว้าอันดับหนึ่งบนตารางคะแนน ALE ด้วยอัตราการผ่านที่ 24.0% พลิกเอาชนะตัวเต็งอย่าง Claude Fable 5 ของ Anthropic ที่เพิ่งเปิดตัวไปได้สำเร็จ โดยโมเดลของ Anthropic ทำคะแนนได้เพียง 22.0% อยู่ในอันดับที่สาม
เป้าหมายหลักของ ALE คือการปิดยุคสมัยแห่งการ 'โกงข้อสอบ' ของปัญญาประดิษฐ์ หลังจากการตรวจสอบอิสระพบว่าโมเดลบางตัวในอดีต เช่น ตระกูล Claude Opus แอบอ่านเฉลยข้อสอบที่ซ่อนอยู่ในประวัติของระบบจัดเก็บไฟล์ (Git history) มากกว่าที่จะแก้ปัญหาจริง เบนช์มาร์กใหม่นี้จึงปิดช่องโหว่ทั้งหมดโดยบังคับให้ AI ทำงานภายใต้กรอบการควบคุมคอมพิวเตอร์แบบทั่วไป (GCUA)
ระบบ GCUA นี้จะประเมินความสามารถของโมเดล AI ใน 5 มิติสำคัญ ได้แก่ สมอง (การคิดวิเคราะห์), ดวงตา (การรับรู้ทางภาพ), ร่างกาย (การควบคุมประสานงาน), และมือ (การเรียกใช้งานเครื่องมือ) ซึ่งผลคะแนนที่ออกมาค่อนข้างต่ำในภาพรวม แสดงให้เห็นว่าแม้แต่โมเดลที่ก้าวหน้าที่สุดในปัจจุบันก็ยังคงล้มเหลวในการทำงานจริงในโลกธุรกิจที่ซับซ้อนอย่างสิ้นเชิง